TTS.ai
- 目录加载中...
核心功能
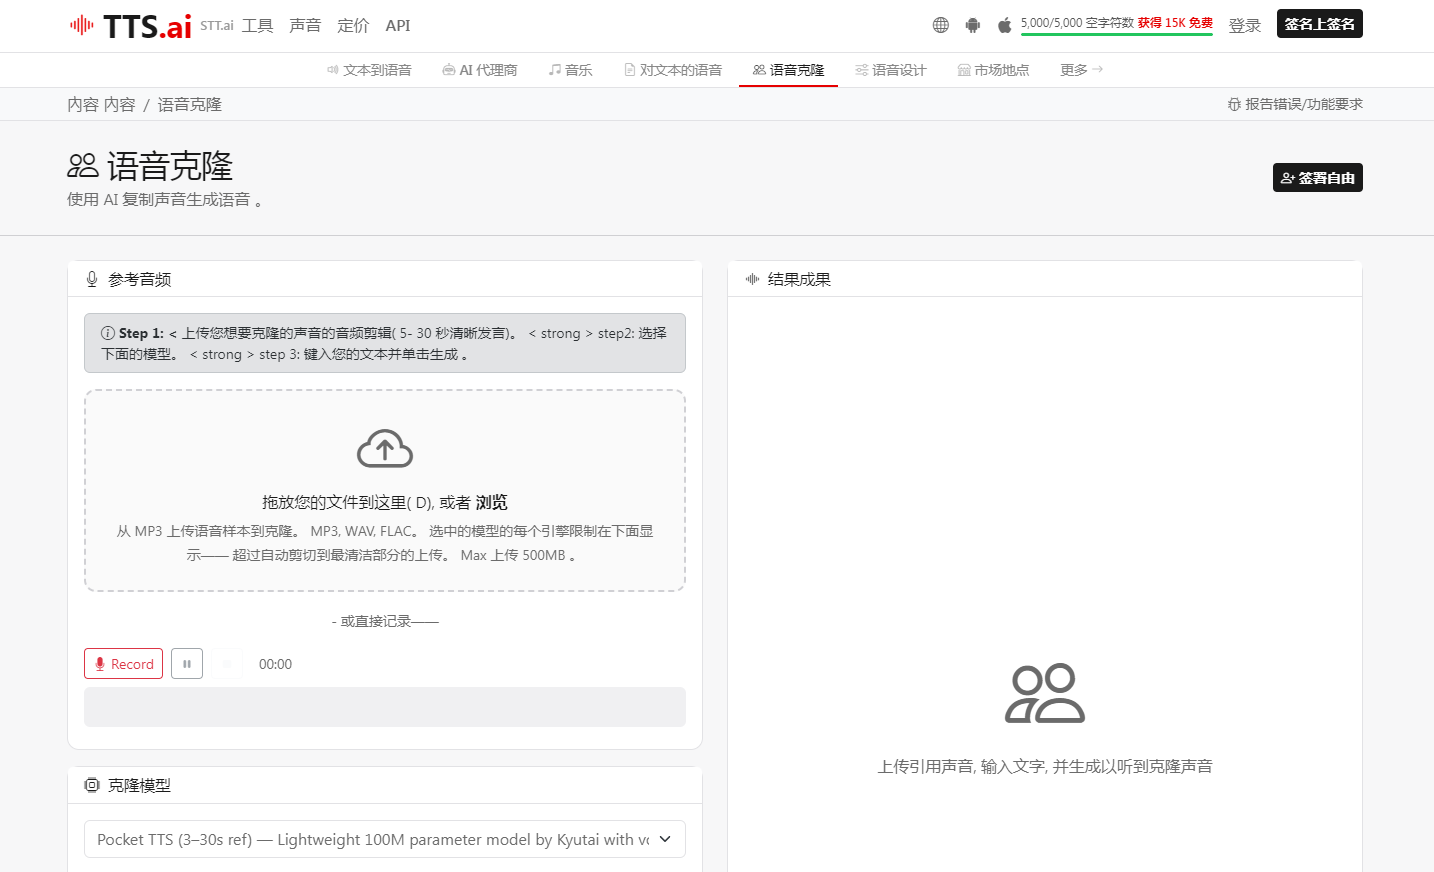
极低门槛的零样本语音克隆
TTS.ai 的语音克隆不需要训练过程。上传一段 5 到 30 秒的参考音频,选择一个支持克隆的模型,输入文本即可生成带有目标音色的语音。平台上不同模型的克隆特性存在差异:CosyVoice 2 擅长跨语种克隆,可以在保留音色身份的前提下输出多达 8 种语言的语音;Chatterbox 在克隆的同时提供了情感控制;Pocket TTS 则是一个仅 1 亿参数的轻量模型,适合对资源占用敏感的场景。这意味着用户不是在“用一个模型做所有事”,而是可以为中文短视频挑一个模型,为多语种有声书换另一个。
多模型路由与质量分层
TTS.ai 将可用的模型按计算成本划为免费、标准和高级三层。免费层涵盖 Piper、VITS、MeloTTS 等轻量模型,不消耗字符额度即可快速合成;标准层包括 Kokoro、CosyVoice 2、Bark 等,自然度更好;高级层的 OpenVoice、Chatterbox、StyleTTS 2 则代表了开源 TTS 中较为接近真人听感的水平。这种分层让用户可以在原型阶段用免费模型跑通流程,在交付阶段再切换到高级模型,而不必一开始就为高质量生成支付全部成本。
跨语种与音色保持
对于需要制作多语言版本的内容,CosyVoice 2 和 GPT-SoVITS 等模型支持用一个语言训练的音色去说另一种语言。用户可以用自己的中文录音克隆声音,然后生成英文、日文或其他语言的语音输出,而不需要分别录制每种语言的参考样本。跨语种输出在口音和韵律上并非完美,但在“保留音色身份”这一核心目标上,它提供了一条无需多语演员的替代路径。
API 与批量处理
TTS.ai 的付费层级均包含 API 访问权限,支持通过 voice_id 复用已保存的克隆声音,而不必在每次请求时重新上传参考音频。平台还支持从 TXT、PDF、EPUB、CSV 等文件批量导入文本,适合有声书章节或产品描述的大规模语音化。输出格式覆盖 MP3 和 WAV,部分场景支持生成 VTT 字幕文件。
适合人群
最适合:需要快速测试多种克隆方案的内容创作者与开发者
TTS.ai 的核心吸引力在于“用同一套额度,试遍不同模型”。如果你不确定 CosyVoice 2 和 Chatterbox 哪个更适合你的口播风格,或者想在 OpenVoice 和 GPT-SoVITS 之间比较中文咬字的自然度,TTS.ai 把这种横向对比的成本压到了最低。对于独立开发者、播客制作者、短视频创作者,以及需要为游戏或动画角色批量生成对白的小型团队,它提供了一个无需分别注册多个平台、无需管理多套计费账户的聚合入口。
也适合:需要跨语种音色一致性的轻量本地化场景
如果品牌或个人 IP 已经用某种语言建立了声音识别度,TTS.ai 的跨语种克隆可以在不重新录制的情况下产出其他语言的版本。对于预算不足以聘请多语配音演员、但又希望保持声音一致性的小型项目,这是一种务实的过渡方案。
不太适合:对克隆精度有录音棚级要求,或对成本高度敏感的高频用户
TTS.ai 的语音克隆按高级模型费率计费,每字符消耗 4 倍于标准模型的额度。这意味着一次不满意的克隆尝试所消耗的预算,是普通 TTS 的 4 倍。如果参考音频本身带有背景噪音或混响,克隆结果的质量会明显下降,而这次失败的尝试已经产生了全额费用。此外,平台本质上是一个开源模型的聚合层,克隆的极致自然度和稳定性上限,取决于底层模型而非平台本身。在追求“几乎无法分辨”的交付标准时,它更适合作为筛选和测试工具,而非最终生产工具。
收费模式
TTS.ai 的计费结构比较独特:订阅决定你拥有多少字符额度以及能否使用 API,而语音克隆本身在消耗字符时适用高级模型的 4 倍费率。换句话说,克隆的“准入”是免费的(免费层也能体验),但“克隆的每一次生成”都比普通合成更贵。
免费层提供 15,000 字符的初始额度以及每日 1,500 字符的补充,无需注册即可在首页进行 500 字符以内的生成测试。免费层覆盖 5 个基础模型,适合验证流程和对比不同模型的听感。克隆音频时,消耗按高级模型 4:1 的比率从字符余额中扣除。
Lite(约 $4/月)与 Starter(约 $7/月) 是低门槛的付费入口,分别提供年度 240 万和 600 万字符,开放全部模型并包含 API 访问权限。**Pro(约 $23/月)** 将速率限制提升至每分钟 60 次请求,适合有生产环境调用需求的用户。更高阶的 Scale、Growth、Professional 和 Enterprise 计划面向大规模批量生成场景,月费从 $249 到 $4999 不等,字符额度从 3000 万到 10 亿每月。此外,平台提供一次性购买的字符包,字符不过期,适合用量波动明显的用户在不承诺订阅的情况下按需补充。
使用方法
第一步:筛选参考音频。 准备一段 5 到 30 秒的清晰单人语音,避免背景噪音、音乐和混响。在付费生成之前,可以先用免费层模型对同一段参考音频做一次克隆测试,用耳朵判断音色相似度是否达到预期——这一步不消耗高级模型的 4 倍费率。
第二步:选择克隆模型。 根据目标语言和用途选择模型。中文口播可优先测试 CosyVoice 2 或 GPT-SoVITS;需要情感表达时尝试 Chatterbox;仅需轻量快速预览时选择 Pocket TTS。在模型页面上传参考音频,或直接录制一段新样本。
第三步:输入文本并生成。 在文本框中键入需要合成的内容,确认语言与参考音频匹配。点击生成后,系统会按所选模型对应的费率扣除字符额度。克隆任务通常按每次 5,000 字符的粒度计费。
第四步:保存声音或导出。 满意的克隆声音可以保存为 voice_id 供后续 API 调用复用,避免每次重新上传参考音频。生成的音频可下载为 MP3 或 WAV,部分模型支持直接输出 VTT 字幕。