
数美科技
- 目录加载中...
核心功能
多维风险标签与精细语义识别
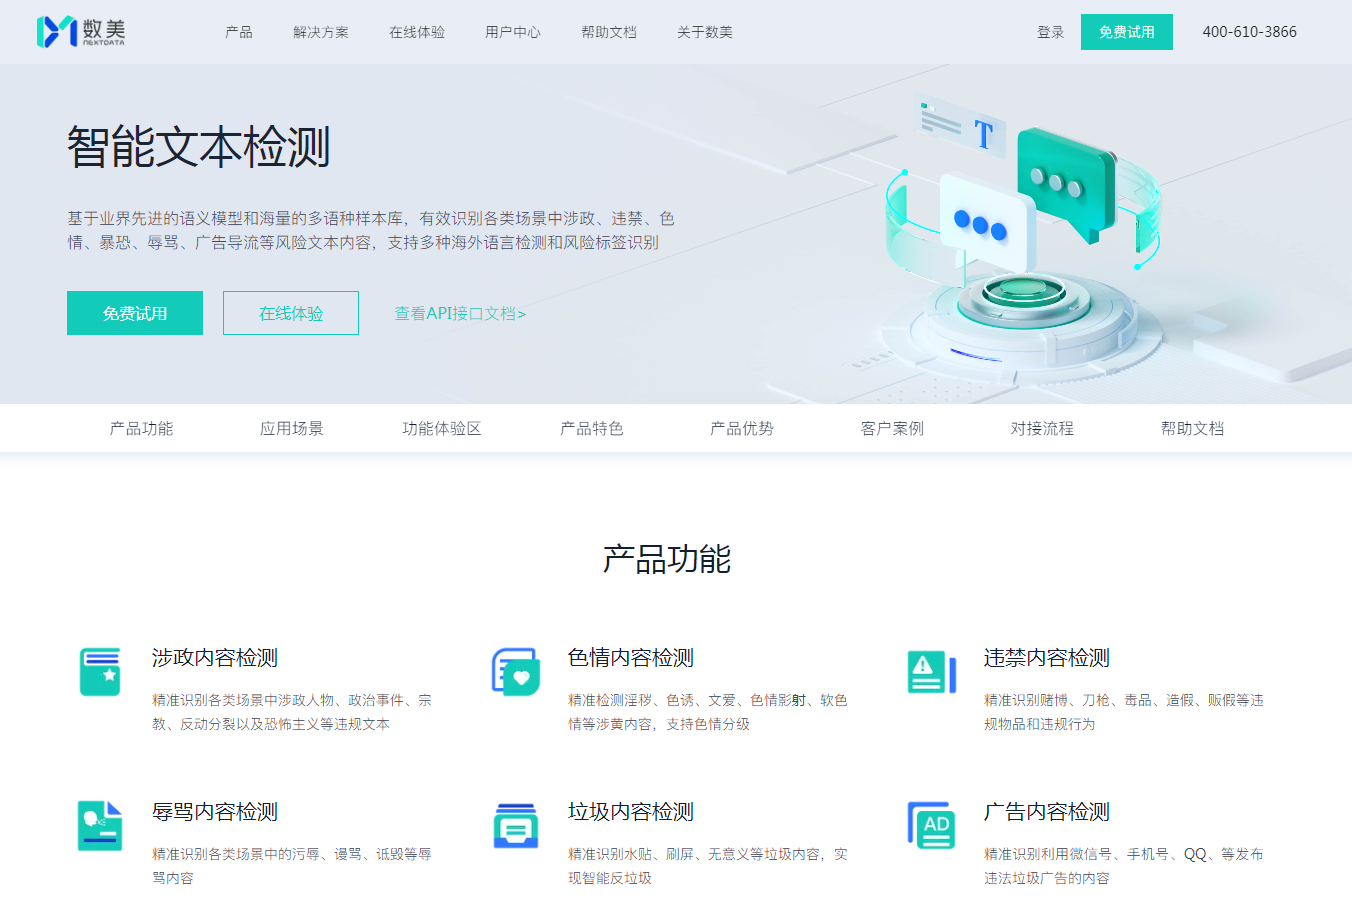
文本检测覆盖涉政、色情、违禁、辱骂、垃圾、广告导流等基础风险维度。其识别不依赖简单的关键词命中,而是基于多类NLP技术融合的语义模型,能有效拦截用谐音、拆字、表情符号承载违规语义的变体广告与绕过策略。平台将FSA算法应用于变体识别,在规则匹配前布防,同时支持emoji和字符表情形态的语义识别。
175种语言与出海本地化策略
针对出海业务,平台支持自动检测175种海外语种,并为英语、阿拉伯语、泰语、印尼语等18种主流语种提供风险标签识别。风控策略可根据不同地区监管政策差异进行本地化部署,让企业在拓展海外市场时,无需在每个目标市场从零搭建本地化审核团队。
自定义敏感词库与账号级风控
在平台预设标签外,企业可维护自定义敏感词库,综合字面与语义判断定向过滤特定场景的内容。平台提供1000多个三级内容标签体系,不同行业可选取匹配的标签组合。系统还会关联用户行为数据做多维判断,对高频违规账号进行识别和标注,实现从内容回溯到账号的深度风控。
适合人群
最适合:UGC体量百万级以上的社交与内容平台
当日均用户生成内容达到百万量级,纯人工审核在成本上不再可行,仅靠关键词又无法应对变体绕过。数美科技的智能文本检测用机器完成第一轮全量筛查,高风险直接拦截,疑似推给人工复核,在保障合规的同时把人力集中在边界案例上。
也适合:正在拓展海外市场的泛娱乐与社交产品
出海合规的复杂性在于语言和法规的双重差异。平台的多语言检测与地区化策略部署,让产品进入新市场时能复用已有的风控基础设施,无需在每个地区单独寻找本地审核供应商。
不太适合:日均内容量极低或预算极度有限的项目
平台采用企业级按量计费,初期需预充值。对于日均只有几十条评论的个人博客或小型论坛,人工审核或轻量级开源方案在成本上更合理。此外,接入需要基础API对接能力,非技术团队在初始集成阶段需要投入开发资源。
收费模式
数美科技的文本检测以SaaS方式交付,核心逻辑是预充值与阶梯计价,而非固定月费订阅或长期免费额度。
平台不提供面向个人开发者的免费试用层。在线体验区可以有限度地测试检测效果,但不构成持续可用的免费额度。正式调用均在付费框架内进行,订单会包含平台使用费与人工服务费。
正式接入后,根据企业订购的调用量区间和审核标签复杂度综合计算单价。对于调用量稳定的大型企业,平台提供年度订阅套餐或包含一定调用量的框架协议,单价会随承诺用量上升而下降。这种模式让成本随业务量弹性伸缩,适合内容量波动或处于增长期的平台。
使用方法
第一步:注册与认证
在官网注册账号并完成企业认证。平台的正式服务面向企业客户,个人身份无法直接开通生产环境的调用权限。
第二步:获取API密钥并选择产品
在控制台中选择天净内容风控下的智能文本检测产品,创建应用并获取API Key与密钥。技术团队可从官方文档中心获取多种主流语言的SDK或RESTful API接入说明。
第三步:配置风控策略
根据业务场景配置检测维度,选择需要开启的风险标签(涉政、色情、广告导流等),上传自定义敏感词库,设定命中后的处置动作(直接拦截、转人工复核或仅记录)。若涉及多语言,在策略中指定目标语种和对应地区的规则集。
第四步:接入业务流并上线
将文本检测接口嵌入内容发布、评论提交、私信发送等业务节点。系统对每条文本实时返回风险标签与置信度,业务侧根据结果执行处置逻辑。后续可在控制台查看调用量、命中分布等数据,据此调整策略阈值。